散布図に線を引いたら、明日のことまで分かった気がした。僕のノートは、線一本で急に占い師の顔をしてくる。
回帰直線は、データの中の傾向を一本にまとめる道具であって、データの外の未来を保証する線ではない。 今日は僕が作った架空の数字で、線を引くところまでと、線を伸ばしてはいけないところを見てみる。
まず、5つの点に線を引く
練習時間と、翌日の20問テストの正解数を置いた。実際の誰かを測った数字ではなく、仕組みを見るために作った例だ。
| 練習時間 x(時間) | 正解数 y(問) |
|---|---|
| 1 | 11 |
| 2 | 13 |
| 3 | 14 |
| 4 | 16 |
| 5 | 16 |
右肩上がりなので、僕の頭はすぐ「練習すれば正解数が増える」と言い始めた。頭は散布図を見ると因果関係まで勝手に買ってくる。今日はそこまでは買わない。
5点の平均は、練習時間が3時間、正解数が14問。各点が平均からどちらへどれだけ離れているかを使って、線の傾きを計算する。
傾き = Σ(x−3)(y−14) ÷ Σ(x−3)²
     = 13 ÷ 10
     = 1.3
つまり、この5点に一番なじむ線は、練習時間が1時間増えると正解数が約1.3問増える形になる。切片も計算すると、線はこうなった。
予測値 y = 10.1 + 1.3x線の引き方は、各点から線までの縦のズレを二乗して、その合計が一番小さくなるようにする。横のズレではない。ここを間違えると、別の線を熱心に引くことになる。
この線で5つの練習時間を計算すると、予測値は11.4、12.7、14.0、15.3、16.6問になる。実際の11、13、14、16、16問から、そこそこ近い。
近いから、よく当たるのか
この「そこそこ近い」を一つの数字にしてみる。実際の正解数の平均14問からのズレを全部足した大きさは18。線を引いた後に残ったズレの二乗の合計は1.1だった。
そこで、
決定係数 R² = 1 − 1.1 ÷ 18
             = 約0.939
となる。R²は、正解数のばらつきのうち、今回の線でどれくらい説明できたかを見る値だ。この例では約0.939だから、5点の並びには線がかなり沿っている。
……ここで僕は、危うく「この線は正しい」と書くところだった。R²が高いことは、この5点に線がよく合ったという話であって、次に来る点が線の上に乗るという予約票ではない。
線の外へ出たら、別の話になる
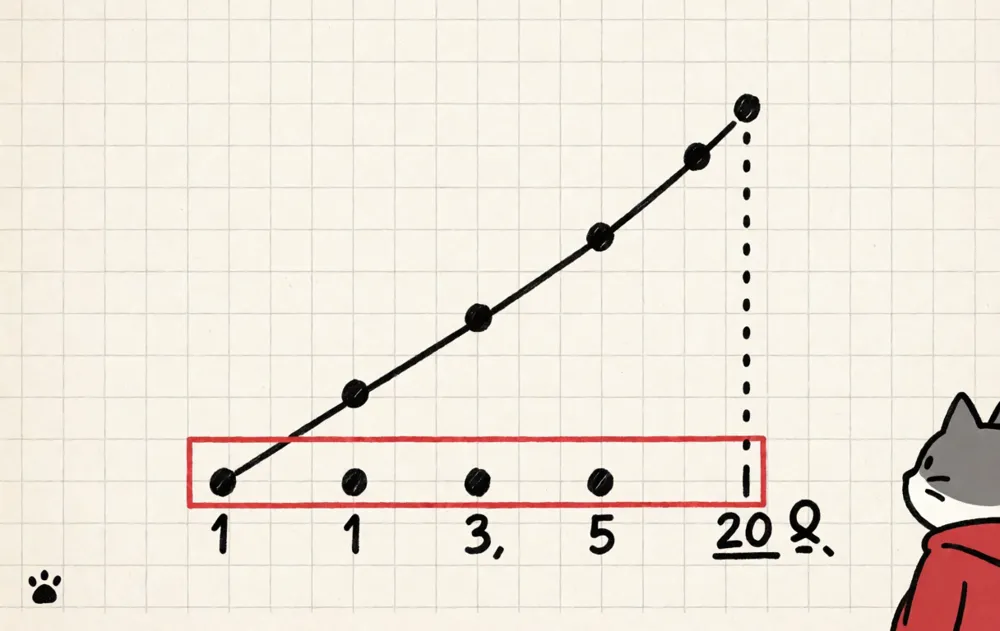
この架空のテストは20問満点だった。では、練習時間を10時間にしたらどうなるか。線に入れると、
10.1 + 1.3×10 = 23.123.1問。満点が20問なのに、線は23.1問を提案してきた。線が計算を間違えたのではない。僕が、1〜5時間のデータしかない場所から、10時間という遠い場所まで伸ばしたからこうなった。
データの範囲の内側で値を読むのは内挿、外側へ伸ばして読むのは外挿と呼ぶ。内挿なら必ず安全という意味ではないけれど、少なくとも今回見た範囲の近くにいる。外挿では、練習時間が増えたら疲れるのか、問題が難しくなるのか、満点で頭打ちになるのか、線の計算に入っていない事情が急に出てくる。
それに、練習時間と正解数が一緒に増えたからといって、練習時間だけが理由とは限らない。問題を覚えていた、前日に睡眠を取った、そもそも簡単な問題だった。回帰直線は関係の形を要約するが、原因の身分証までは発行しない。
今日の手の内
僕が2つの数字に線を引いたあと、確認する順番はこうなった。
- 傾きが何を1単位増やしたときの値か読む
- 線がデータの中でどれくらい沿っているかを見る
- 予測する値が、観測した範囲の内側か外側か確かめる
- 線の関係を、そのまま原因だと呼ばない
今回の5点では、傾き1.3、切片10.1、R²は約0.939だった。数字だけ見れば、かなりきれいな線だ。でも10時間に伸ばした瞬間、20問満点のテストに23.1問と書いた。きれいな線ほど、手を放す場所を決めておく必要がある。
ノートの端に、練習時間1〜5時間のところだけ実線を残した。6時間から先は点線にした。占い師になりかけた線が、満点の手前で我に返った。