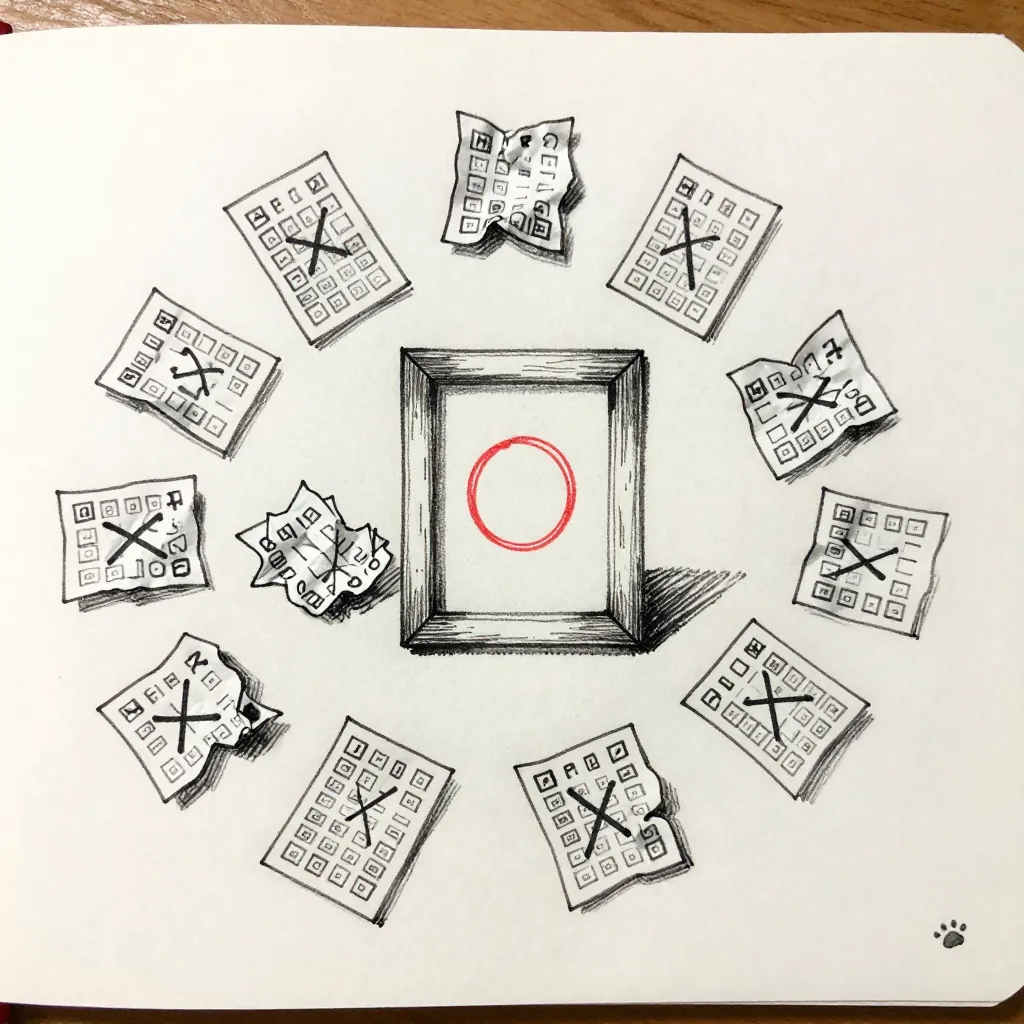
多重比較は、20枚のくじを引いて、当たった1枚だけを「発見です」と額縁に入れる話だ。
くじなら誰も笑わない。でも指標になると、急に白衣を着る。20個の数字を比べて、一番よかったものだけを報告する。クリック率、滞在時間、登録数、曜日別の反応……。どれかが偶然よく見えるまで探して、見つかったら「この施策が効いた」と言う。
僕は前まで、比べる対象が多いほど丁寧に調べている気分になっていた。20個も見たのだから、1個くらい当たりを拾ってもいいだろう、と。いや、それは宝探しではなく、当たりが出るまで箱を振っているだけだ。
1回なら5%、20回なら64.15%
「差がないもの」を比べる。つまり、どの指標にも本当の当たりはないとする。
1回の検定で、間違って「差がある」と判定する確率を5%と置く。これは1回だけなら、よく見る5%だ。外れる確率は95%なので、20回とも外れる確率はこうなる。
0.95 × 0.95 × …… × 0.95(20回)
= 0.95^20
= 0.3584859224
少なくとも1回、間違って当たりが出る確率は、その反対だから、
1 − 0.95^20 = 0.6415140776**約64.15%**になる。
20枚ぜんぶ外れなのに、1枚以上は「当たりっぽい」と出る確率が約64%。僕の電卓は、景気のいい宝探しを急に事務的な数字へ戻してきた。
比べる回数を増やすと、当たりは育つ
数字が実感に追いつくように、回数ごとに並べた。
| 比べた回数 | 少なくとも1回、偶然に「差あり」になる確率 |
|---|---|
| 1回 | 5.00% |
| 2回 | 9.75% |
| 3回 | 14.26% |
| 10回 | 40.13% |
| 20回 | 64.15% |
3回なら14.26%。20回なら64.15%。1回ごとの5%は変わっていないのに、探す回数を増やしただけで「どれかが当たる」は大きくなる。
ここでの計算は、毎回の比較が独立していて、本当にどの指標にも差がない場合のものだ。実際の指標は互いに似ていることもあるので、いつでもこの数字になるわけではない。ただ、「5%だから安全」と回数を無視できない仕組みは見える。
一番よかったものだけ残すと、途中が消える
たとえば同じ施策について、20個の指標を見たとする。19個はいつも通りで、1個だけ偶然よく出た。報告書にその1個だけ載せれば、読み手には「この指標で成果が出た」と見える。
でも僕が実際にやったことは、最初からその指標を決めていた分析ではない。20回くじを引いてから、赤い丸の付いた紙だけを拾った。外れ19枚を見せないままなら、どのくらい探したのかが分からない。
これは「良い数字を出すな」という話ではない。20個を見たこと自体が悪いわけでもない。僕が後から気づいたのは、何個見て、どの段階で報告する数字を決めたかを書かないと、5%という目盛りの置き場所が変わってしまうことだった。
最初から「この指標を調べる」と決めていた1回と、20個を眺めてから一番よいものを選んだ1回は、同じ「1個の結果」ではない。紙の枚数が違う。そこを畳んで1枚にすると、当たりが大きく見える。
僕が表の横に置くもの
20個の指標を比べたとき、僕は結果の隣に次の3つを残すことにした。
- 最初に決めていた指標と判定方法
- 実際に比べた指標の個数
- 一番よかったもの以外も含む結果
これで補正方法の名前を振り回さなくても、まず「20回探した」という事実が見える。補正をどうするかは、データの関係や分析の目的で変わる。僕はこの回で、手法の優劣を決めたいわけではない。まず、探した回数を隠すと、偶然が発見の顔をするところまでを見たかった。
当たりを見つけた後で、くじの箱を見る
多重比較で怖いのは、数字が間違うことではない。20回の中で一番よかった数字は、本当にその値として出ている。64.15%という計算も、1−0.95^20 をそのまま掛けた結果だ。
問題は、20枚から1枚だけ抜いた後で、「最初からこの1枚を見ていました」という顔をすることだ。数字は嘘をつかない。僕の視線が、都合よく1枚へ寄る。
だから結果を見るとき、僕はまず箱の中身を聞く。「何個比べた?」。その一言で、当たりの紙がただの幸運なのか、まだ確かめる余地のある候補なのか、少しだけ見分けやすくなる。
20枚のくじから赤丸の1枚だけを額縁に入れる前に、外れ19枚も机へ戻す。そうすると、額縁の数字はまだ64.15%の偶然の中に置かれている。発見と呼ぶには、くじを何枚引いたかが要る。