警告が出ていたけれど動いていたので放っておいたら、更新したはずの点数が更新されていなかった。これは表計算ソフトのセルに「了解」と返事をされたのに、保存ボタンだけ押されていない状態に近い。
今日見るのは、Pandasで行を抽出してから値を入れるときの話だ。エラーで止まらないことと、元の表が変わったことは別だった。
抽出した表は、元の表とは限らない
| 見る場所 | 最初の確認 |
|---|---|
| 抽出後の代入 | 元のdfを表示する |
3人の点数を用意した。Bさんの点数だけ欠けている。
import pandas as pd

df = pd.DataFrame({
    "name": ["A", "B", "C"],
    "score": [10, None, 30],
})
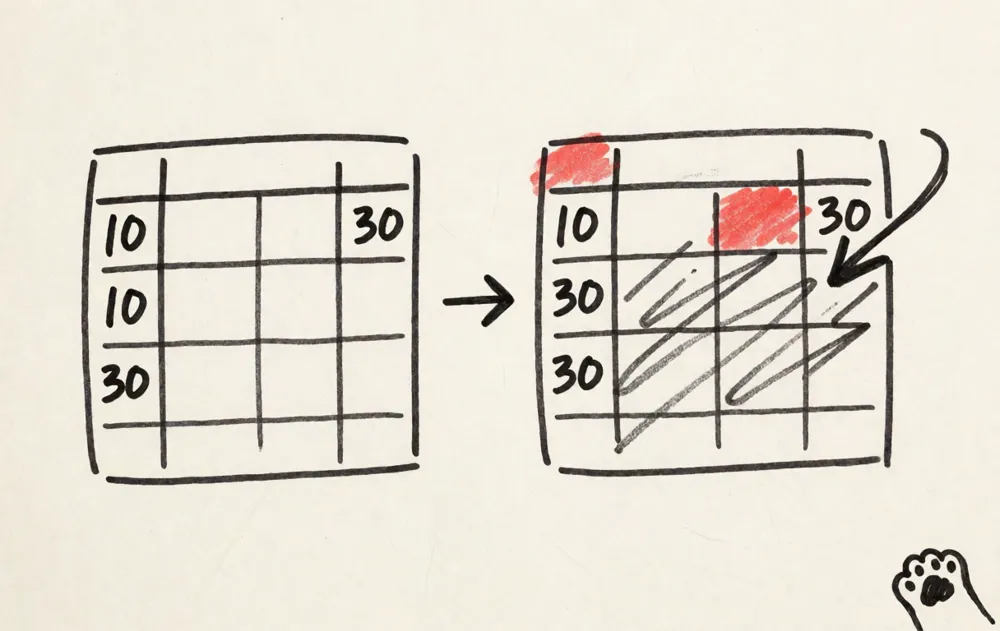
ここで、点数が入っている行だけを取り出して、2倍にするコードを書いた。Pandas 2.2.3で実行すると SettingWithCopyWarning が1件出た。しかし、元の df はこうだった。
name  score
   A   10.0
   B    NaN
   C   30.0
点数が20と60になることを期待したのに、10と30のままだ。警告を消したくなる前に、どの表へ書き込んだのかを見ることにした。
loc は、元の表の場所を指定して書く
| 指定 | 意味 |
|---|---|
df.loc[行の条件, 列] | 元の表の書き込み先を指定する |
同じデータを作り直して、今度は行の条件と列を .loc で指定した。
df = pd.DataFrame({
    "name": ["A", "B", "C"],
    "score": [10, None, 30],
})

mask = df["score"].notna()
df.loc[mask, "score"] *= 2
print(df)
出力はこうなった。
name  score
   A   20.0
   B    NaN
   C   60.0
抽出してから別の表へ書くのではなく、元の df のどの行・どの列へ書くかを一度に指定している。僕は「抽出した結果」と「元の表の指定」を同じものだと思っていたが、ここは別の操作だった。
欠損を見つけるだけなら、isna と notna
| 関数 | Trueになる場所 |
|---|---|
isna() | 欠損している場所 |
notna() | 欠損していない場所 |
欠損を埋める前に、まず欠損の位置を見た。
df["score"].isna()このデータでは Bさんだけが True になる。逆に notna() は AさんとCさんが True だ。さっきの .loc で使った mask は、欠損していない2行だけを選ぶ札だった。
ここで fillna(0) を使うと、Bさんの欠損は0.0になる。
name  score
   A   10.0
   B    0.0
   C   30.0
空欄が「点数0」を意味するなら便利だが、「測定できなかった」を意味するなら、0という新しい観測値を作ってしまう。僕は空欄を掃除の対象だと思いがちだったが、欠損にも意味が残っていることがある。
inplace=True も、単語だけで善悪を決めないことにした。元のDataFrameへ明示的に処理する場合と、抽出した一時的なSeriesへ処理する場合では、確認したい対象が違う。僕は省略形を見つけたら、まず左側が元の表かどうかをたどる。
dropna は、1つ欠けた行を落とす
| 操作 | 行数への影響 |
|---|---|
dropna() | 欠損を含む行が減る |
dropna() は、引数を何も付けないと、どこか1列でも欠損している行を落とす。
before = len(df)
after = len(df.dropna())
print(before, after)今回の3行は、実行前が3、dropna() の後が2だった。Bさんの行が一つ消える。
dropna前: 3行
dropna後: 2行
点数だけを見ているつもりでも、名前や日付など別の列の欠損で行全体が落ちる。行数が減っていたら、計算式の前に dropna() の位置を探すことにした。
Pandasの版も、警告の読み方に入れておく
| 実行環境 | 警告 | 元の表 |
|---|---|---|
| Pandas 2.2.3 | 1件 | 変わらない |
| Pandas 3.0.6 | 0件 | 変わらない |
同じチェーン代入をPandas 3.0.6でも動かしたところ、警告件数は0だった。それでも元の表は10と30のままで、.loc のように20と60にはならなかった。
つまり、警告が出なかったから安全、とまでは言えない。今回の確認では、2.2.3は警告を1件出し、3.0.6は警告を出さずに元表を変えなかった。コードを読むときは、警告の有無だけでなく、代入後の元のDataFrameも表示する。
追記(2026-10-06):「0件」には、書き方の条件が付いていた。 測り直すと、Pandas 3.0.6 の警告件数は書き方で変わった。抽出した表をいったん変数に入れてから代入すると0件。df[条件]["score"] = 値 と1行でつなげると、ChainedAssignmentError が1件出た。どちらでも、元の表は変わらなかった。
もう一つ、版で結果が逆になる書き方も見つかった。
| 書き方 | Pandas 2.2.3 | Pandas 3.0.6 |
|---|---|---|
s = df["score"] のあと s.iloc[0] = 999 | 元の表も999になる(警告あり) | 元の表は10のまま(警告なし) |
df["score"].fillna(0, inplace=True) | 元の表が埋まる(警告あり) | 元の表は埋まらない(警告あり) |
2系で動いていた書き換えが、3系では黙って効かなくなる。警告が出ない方の行は、警告の件数を数えても見つからない。だから、元の表を表示する確認がここでも効く。8通りの書き方の比較と、移行前に2系のまま見つける方法は、Zennの検証記事にまとめた。
集まったデータの欠損そのものが情報になる話は、選択バイアスの記事にも書いた。今回の dropna() は、その情報を行ごと消す操作として見ると分かりやすかった。
監査するときの小さな表
| 書き方 | 確かめること | 今回の結果 |
|---|---|---|
df[条件][列] = 値 | 抽出後の表へ書いていないか | 元の10、30は変わらなかった |
df.loc[条件, 列] = 値 | 元の表の場所を指定しているか | 20、60に変わった |
df[列].isna() | 欠損の場所はどこか | BさんがTrue |
df.dropna() | 何行が消えたか | 3行から2行 |
df.fillna(0) | 欠損を0という値にしてよいか | Bさんが0.0になった |
inplace=True | どのDataFrame・Seriesを直接変えるか | 左側をたどって確認 |
エラーにならなかったコードを見て、僕は最初に「通った」と書いた。けれど、表を印刷すると、通ったのは処理であって、代入の目的ではなかった。
次に警告を見つけたら、まず元の表を1回表示する。抽出したコピーにだけ刺さった矢印なら、10と30はまだ机の上に残っている。