スーパーの隅っこに、りんごを1個ずつ手に取って量れる台があった。会計まで少し時間があったから、暇つぶしに5個くらい適当に持ち上げて、量りに乗せてみた。280g、265g、300g、270g、290g。
バラバラなのに、バラバラの仕方が上品というか、280g前後に寄ってる。極端に軽いのも、極端に重いのも出てこない。
確率で決まる数字ってのは、繰り返すとどんな形に積み上がるかの「型紙」を、現象ごとに最初から持たされてるらしい。 りんごの重さは真ん中がふくらんだ山になるけど、たとえばコンビニのレジに客が来るタイミングは、山どころか、来ない時間がずっと続いた後にどっと来る、みたいなムラの形になる。同じ「確率任せの数字」なのに、そもそも形からして種類が違う。
(大きい数を集めれば、そのうちみんな富士山みたいな形になってくれると思ってた。それ、半分正解で半分不正解だった。)
山になる理由、山にならない理由
さっきのりんご、なんで真ん中に寄るのか考えてみた。りんご1個の重さは、日当たり・水の量・木のどの枝についてたか・収穫のタイミング……色んな小さい要因が足し算されて決まってるはずだ。小さい要因がたくさん足し算されると、結果はだいたい真ん中に寄って、両端に行くほど少なくなる山の形になりやすいらしい。身長も同じ理屈で、遺伝や栄養や生活習慣が積み重なって1個の数字に落ち着くから、山になる。
じゃあ、レジの行列はなんで山にならないんだろう。
行列は「足し算」じゃなくて「独立に起きる出来事の数」だ。次の客がいつ来るかは、前の客がいつ来たかとほとんど関係ない。関係ない出来事がポツポツ起きるのを数えると、山じゃなくて、0回・1回・2回……が起きる確率が右肩下がりに減っていく、非対称な形になる。足し算で寄っていくタイプの数字と、数え上げるタイプの数字は、最初から別の形をしてる。
実際に3つ並べてみる
言葉だけだと分かった気になるので、代表的な3つを並べてみた。
| 名前 | 何を数えてるか | 例 | 形の癖 |
|---|---|---|---|
| 二項分布 | 「はい/いいえ」を決まった回数だけ繰り返した結果 | コインを100回投げた「表の数」 | 回数が多いと山に近づく。ただし上限と下限がある(0〜100回) |
| ポアソン分布 | 決まった時間・範囲の中で、バラバラに起きる出来事の数 | 1日に来る問い合わせの件数 | 0付近が多く、右に長く裾を引く。上限がない |
| 正規分布 | たくさんの小さい要因が足し算された結果 | たくさんの要因が積み重なった身長 | 左右対称の山。裾は両方ともなだらか |
コイン100回、表の数はだいたい50回あたりに集まって、山っぽい形になる。でも「絶対50回に集まる」わけじゃなく、0回や100回になる可能性もゼロではない、ただしめちゃくちゃ低い、という上限・下限つきの山だ。
問い合わせ件数のほうは、山にすらならないことがある。1日の平均が2件だとしたら、実際に一番多いのは1件か2件の日で、0件の日もそこそこある。3件、4件と増えるにつれて出現率は下がっていくけど、ゼロにはならない。マイナスの日はありえないから、左側はゼロで急に切れて、右側にはロングテールが伸びる非対称な形になる。
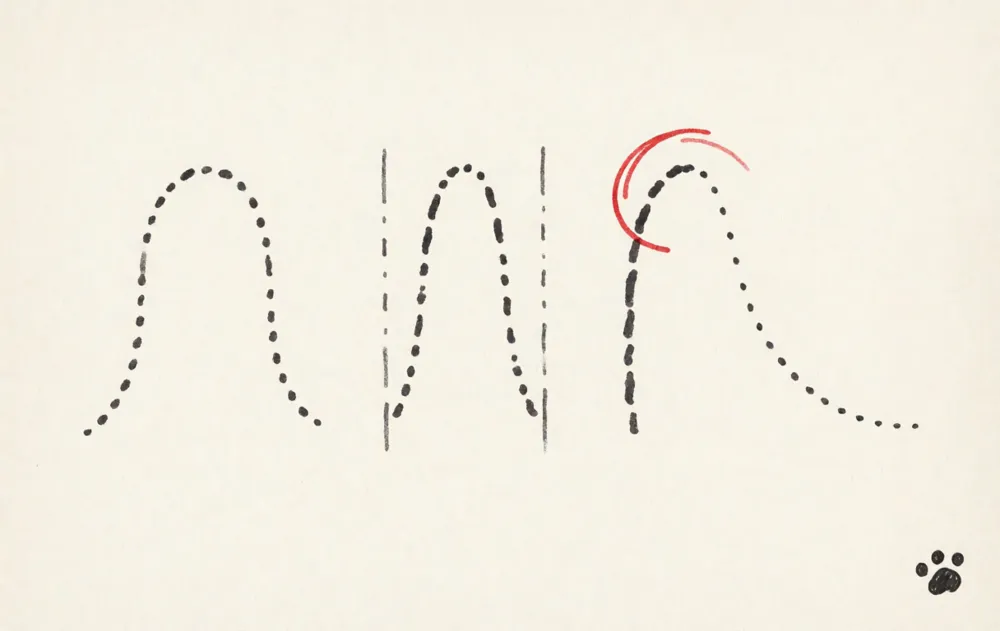
正規分布だけが「みんなが思ってる山」で、二項分布は「条件付きの山」、ポアソン分布は「そもそも山じゃない」。3つとも”確率で決まる数字”という点では同じ仲間なのに、形の癖はまるで別物だった。
じゃあ、データを取ったら、とりあえず正規分布に当てはめとけばいいってこと?
……それをやると、右に裾が伸びてるだけのデータに「山の中心」を無理やり探しに行くことになる。まず、その数字が「足し算」なのか「数え上げ」なのか、そこを見るほうが先だと思う。
形を先に決めてから、数える
正規分布は便利すぎて、なんでも当てはめたくなる。でも今日並べてみて分かったのは、山になるかどうかは後から確かめることじゃなくて、その数字が「何を足し算してるか」「何を数え上げてるか」で最初から決まってるってことだった。
りんごの量り売り台に戻って、もう5個乗せてみた。278g、310g、255g、290g、265g。合わせて10個、280gあたりに集まったまま、極端に軽いのも重いのもまだ出てこない。
台に戻ってきた僕を見て、店員さんがちょっと変な顔をした。買わずに量るだけの客、たぶんあんまりいない。