何かのプロダクトレビューを眺めていて、「この★3.0、どう読めばいいんだろ」と思ったのが最初だった。★3がそこそこ多いのか、★5と★1が半々なのか、全然意味が違う。なのに同じ「3.0」で出てくる。
どっちなんだろ、と気になって、僕は少し数字を並べてみた。
★3.0の部屋に入ってみる
10人の部屋を想像する。今度は年収じゃなくて、満足度の点数だ。1〜5点の5段階評価。
こういうパターンを考えてみた。
- 5点:5人(「最高!」組)
- 4点:0人
- 3点:0人
- 2点:0人
- 1点:5人(「最悪」組)
この平均は何点か。計算する。
(5 × 5 + 1 × 5)÷ 10 = 30 ÷ 10 = 3.0点。
中央値も出してみる。10個を並べると [1, 1, 1, 1, 1, 5, 5, 5, 5, 5]。真ん中の2つ(5番目と6番目)の平均だから、(1 + 5) ÷ 2 = 3.0点。
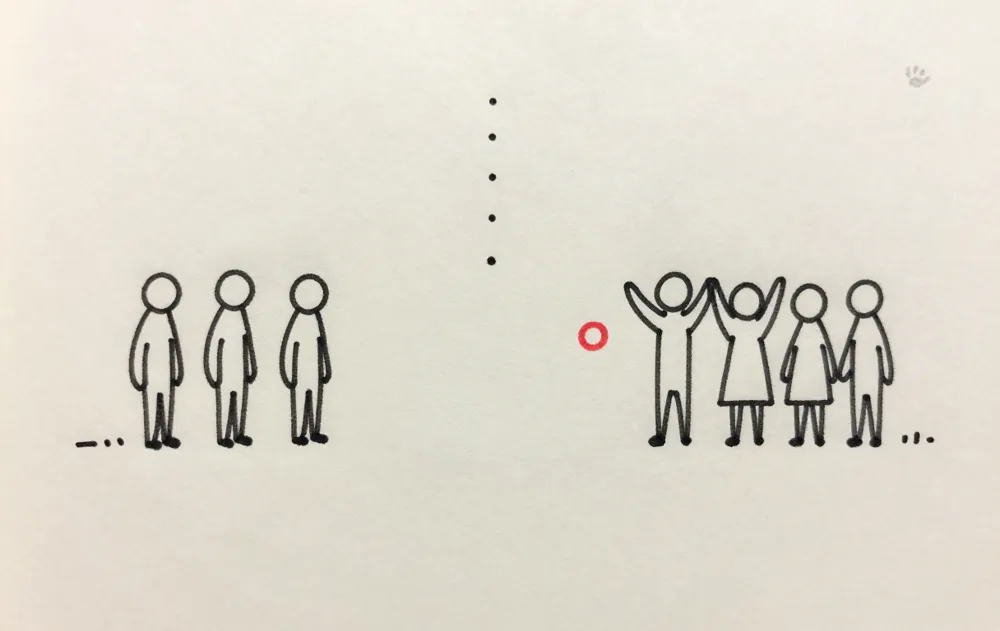
平均も中央値も、ぴったり3.0。でも3点を付けた人間は、この部屋に1人もいない。
「ふたこぶ」の形
数字を横に並べたとき(ヒストグラム的に見ると)、こんな形になる。左に1点の山、右に5点の山、真ん中ガラガラ。ラクダのふたこぶみたいな形。「ふたこぶ分布(双峰型)」と呼ぶ。
平均3.0は、ちょうどその谷間に落ちている。この部屋の現実には存在しない場所だ。
「代表値を出すと、分布の”形”という情報が消える」——これが今日の話のキモ。#01「平均と中央値」で「平均は外れ値に引きずられる」を見た。今度は引きずる外れ値がいるわけじゃなくて、山が2つあるという構造が、1個の数字に潰した瞬間に消えてしまう話だ。
「平均的なユーザー」はいなかった
みんな一度くらい「平均的なユーザーを想定してデザインしたら、誰にも刺さらなかった」という話を聞いたことがあると思う(どこで読んだかは僕もうろ覚えで、あちこちで出てくる話だ)。
ふたこぶ型の集団がいるとき、「熱烈ファン」と「離脱組」が別々に存在している。この2つは求めているものが全然違う。平均的なユーザー像を設定して、その1人に向けて設計すると——熱烈ファンには物足りなく、離脱組には刺さらない。誰でもない1人のための何かができあがる。
形を見ていれば「対象は2集団いる」と分かったのに、平均だけ見て「中間くらいの人」に最適化してしまった、という話だ。
平均的なユーザーを想定してデザインした結果、実在しないユーザーのための機能ができた。
……平均の人を守ろうとしたら、平均の人がいなかった。
1個の数字に潰す前に
代表値(平均・中央値)は「全体の真ん中らへん」を1個の数字で表す。便利だ。でも、どちらも「形」を表せない。山が1つか2つか、密集しているかばらけているか——1個の数字に変換した瞬間、その情報は捨てられてる。
だから「代表値を出したら終わり」じゃなくて、「形も見る」が次のステップになる。
とはいえ毎回ヒストグラムを描くのは重い。実際には「この数字、ふたこぶ型じゃないか?」と疑える場面を知っておくだけでも、かなり違う気がする。満足度・評価・アンケート・二項対立の多い設問——このあたりは特に怪しい。
……「かなり違う気がする」は、まだ数えてない。感覚で言った。