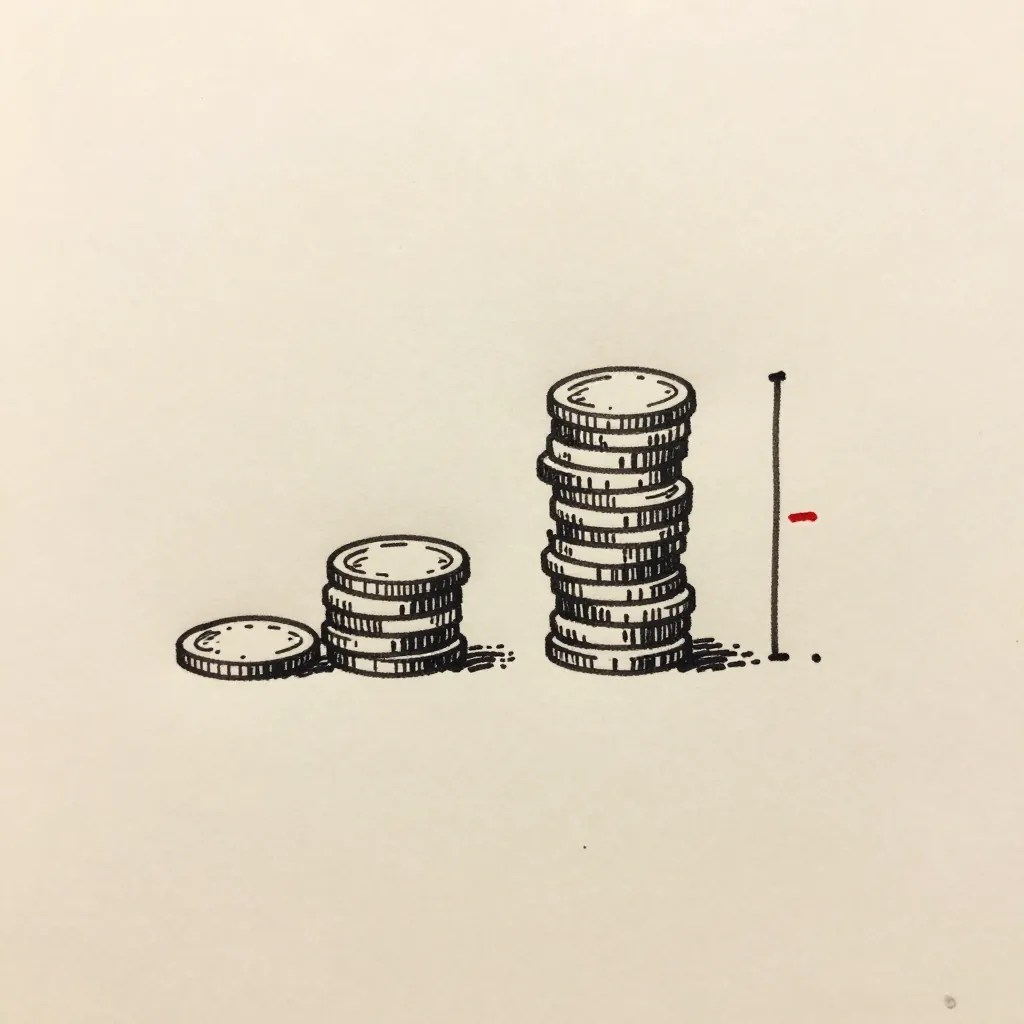
オンライン会議の投票ボタンで、10人中7人が賛成した。僕はその瞬間、世の中の70%が賛成したような顔をしてしまった。参加者、10人しかいないのに。
標本平均は、同じ母集団から取り直すたびに揺れる。そして人数を増やすと、その揺れは1/√nの速さでしか縮まらない。 これが今日の話だ。人数を2倍にしたら精度も2倍、ではない。数字の世界、そこだけ妙に割高な料金体系になっている。
100人ぶんの平均を、何度も作る
まず、実際の調査結果ではなく、仕組みを見るための架空のコインを用意した。表が出る確率は50%。これを100回投げて、表の割合を「標本平均」と呼ぶことにする。
1回目は56回が表で、平均は56%。2回目は47回で47%。3回目は51回。コインの性能を変えたわけではないのに、取り出した100回ぶんの平均が少しずつ動く。
ここで「本当の平均は50%なのだから、56%は間違い」と切り捨てると、話が早すぎる。100回ぶんだけを見ているから、たまたま表が多い側に寄った。別の100回を投げれば、今度は47%側に寄るかもしれない。
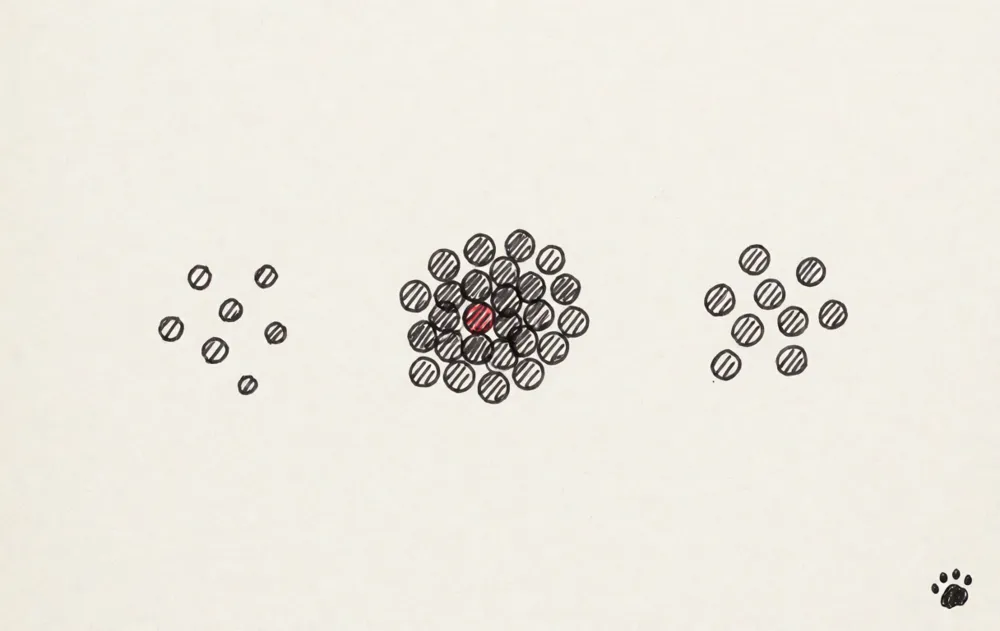
標本平均にも、分布がある
100回投げる作業を何度も繰り返すと、56%、47%、51%のような標本平均がたくさんできる。個々の数字ではなく、その数字たちの並びを見ると、50%の近くが多く、端の数字は少ない山になる。
つまり、コインそのものの表の確率だけでなく、「100回投げたときの平均がどのあたりに出やすいか」も分布を持つ。標本平均の分布、という名前のままの仕組みだ。平均を一個に潰したつもりが、その平均たちにも散らばりがある。数字が入れ子になっている。
「元のコインがどんな確率分布でも、標本を十分に取って平均を作ると、標本平均は山型に寄っていくことが多い」と説明する考え方に、中心極限定理という名前が付いている。名前は立派だが、今の僕が使う理解はこれくらいでいい。元の一回一回が多少いびつでも、平均を何度も作ると、平均のほうは中央へ集まる。
400人集めて、ようやく揺れが半分
コインの表の割合の揺れを、ざっくり計算してみる。表が50%のとき、100回の標本平均の標準誤差は、
- 0.5 × 0.5 ÷ 100 = 0.0025
- √0.0025 = 0.05(5ポイント)
という大きさになる。同じ計算を400回でやると、
- 0.5 × 0.5 ÷ 400 = 0.000625
- √0.000625 = 0.025(2.5ポイント)
になる。人数を4倍にして、揺れが半分。100人から200人に増やしただけなら、5ポイントが約3.5ポイントになる程度だ。頑張ったわりに、縮み方が控えめである。
これは「400人なら必ず誤差2.5ポイント以内」という保証ではない。標準誤差は、標本平均がどれくらい揺れやすいかを見る目安だ。そこを保証書みたいに扱うと、また数字に余計な仕事をさせることになる。
4倍払って2倍の精度
じゃあ、調査の人数を増やせば、いくらでも正確になる?
……理屈の上では揺れは縮む。ただし、精度を2倍にしたければ人数は4倍いる。100人ぶんの予算で400人の精度を買おうとするのは、さすがに店員さんも困る。
標本を増やすのは、もちろん意味がある。ただ「もう100人追加したから、精度もかなり上がったはず」と思ったときは、1/√nを思い出す。人数は増える。精度も上がる。でも、同じ勢いでは上がらない。
標本平均は、ひとつの答えではなく、取り方を変えるたびに揺れる答えの集まりだった。100回から400回へ増やすと、その集まりは50%の近くへ少し細くなる。細くするには、4倍のコインが要る。
次に投票ボタンで7人中7人が賛成していても、僕はまず参加者の人数を見る。10人なら、まだコインを10回投げたくらいの景色だ。400人なら少し落ち着くけれど、4倍ぶんの会議室と飲み物が必要になる。精度は上がる。請求書も上がる。