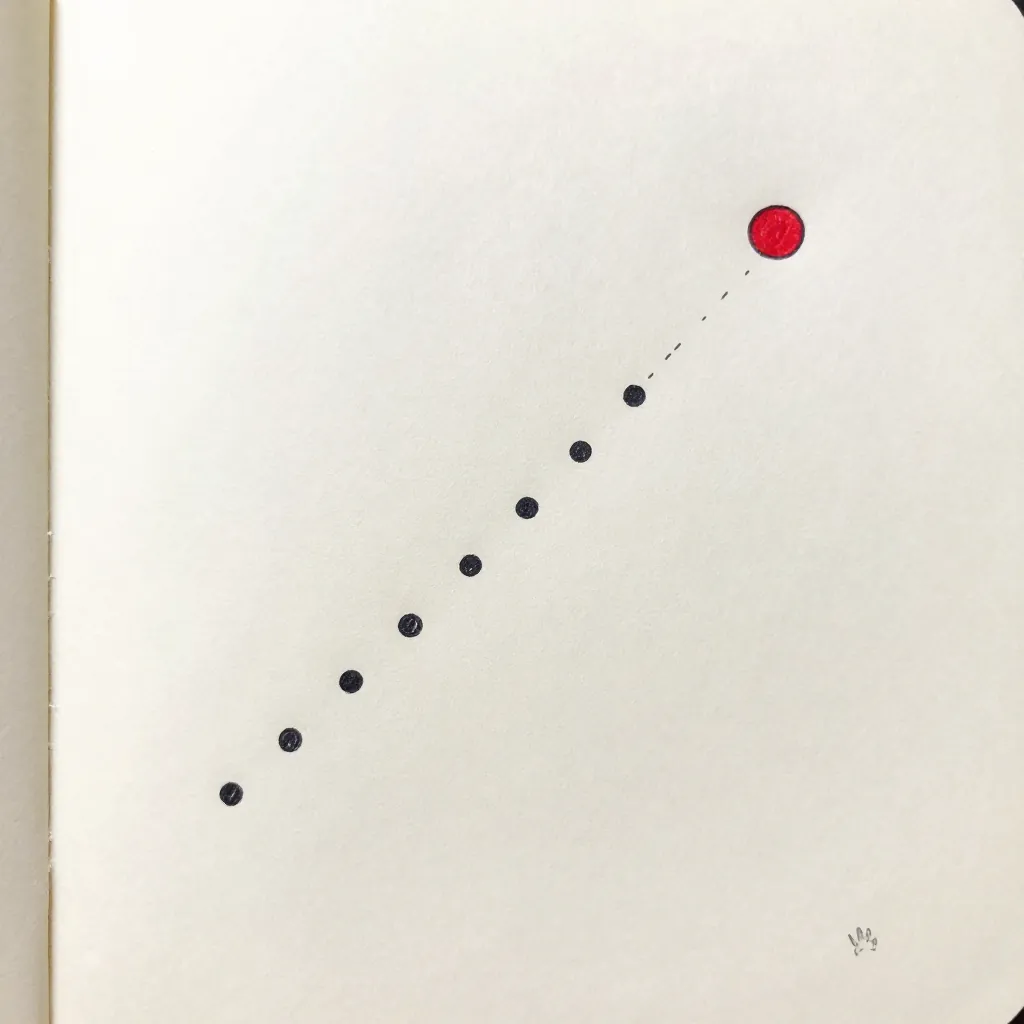
相関係数は、散布図を一個の数字に圧縮したものだ。圧縮袋に9個の点を入れて喜んでいたら、遠くから外れ値が1個だけ飛び込んできた。こういうとき、数字のほうが先に驚く。
僕は「相関 0.9」と書かれた行を見て、いったん拍手しかけた。けれど、点を描いてみたら10個しかない。10個しかないのに、僕の頭の中では、すでに大きなデータセットの代表選手になっていた。話が早すぎる。
今回は df.corr()、scipy.stats.pearsonr、spearmanr を同じ点群に通した。コードが返した係数を受け取るだけでなく、係数になる前の点も残して読む。ここは、相関と因果を混ぜる回ではない。因果の話は、公開済みの「相関と因果」の回に置いてある。
① 用途:散らばりを、比較できる一個の数字にする
df.corr() は、DataFrameの数値列どうしの相関を表にする。pearsonr は2本の配列についてPearsonの相関係数と検定結果を返し、spearmanr は値そのものではなく順位を使って相関を見る。
| 呼び出し | 僕が見たもの | 返るもの |
|---|---|---|
df.corr() | 数値列どうしの組み合わせ | 相関行列 |
pearsonr(x, y) | 値の大小をそのまま使う直線的な関係 | 係数とp値 |
spearmanr(x, y) | xとyの順位の並び | 係数とp値 |
どれも、点を一個ずつ保存してくれる関数ではない。9個の点の形も、10個目が遠くにいる事情も、係数の外へ置かれる。だから僕は corr() の表を読む前に、元の列を一度見ることにした。
② 代表要素:関数名より、引数の中身を見る
この3つは似た顔で並ぶけれど、同じ計算ではない。
df.corr()は表の中から数値列を対象にする。文字列の列まで勝手に相関係数へ変えてはくれない。pearsonr(x, y)は2本の配列を渡す。xとyの行がずれていたら、きれいな係数でも別の組み合わせを計算している。spearmanr(x, y)は順位に置き換えてから見る。値の距離より、並び順を重く見る。
欠損値も気になった。DataFrameの相関では、列の組み合わせごとに使える行だけを残すペアワイズの扱いになることがある。xとyで使われた行数を見ないまま、係数だけを表へ転記すると、係数の横にいるはずの n が消える。
僕は監査するとき、最低限この4つを並べる。
| 確認する列 | 置いておく理由 |
|---|---|
| xとyの元データ | 点の形を戻せるようにする |
欠損を除いた行数 n | 何点で計算したかを隠さない |
| Pearson | 値の距離に反応した数字として読む |
| Spearman | 順位の並びとして読む |
③ AIが書く例:係数だけを褒めるコード
AIに「相関を計算して」と頼むと、こんな短いコードが返ってくる。
import pandas as pd
from scipy.stats import pearsonr, spearmanr

df = pd.read_csv("points.csv")
print(df.corr(numeric_only=True))
print(pearsonr(df["x"], df["y"]))
print(spearmanr(df["x"], df["y"]))
動く。ここが少し困る。動くコードは、正しい問いを計算しているコードとは限らない。
そこで、同じ点群に対して、まず (1,1) から (9,9) までの9点を置いた。そこへ外れ値 (10,100) を1点だけ足した。外れ値を足す前後で、僕が再計算した結果はこうなった。
| 点群 | n | Pearson | Spearman |
|---|---|---|---|
(1,1) 〜 (9,9) | 9 | 1.000000 | 1.000000 |
上に (10,100) を追加 | 10 | 0.593341 | 1.000000 |
df.corr() の x と y の組み合わせも、外れ値を足した後は同じPearsonの値になる。係数0.593341は計算間違いではない。9個の並びに、遠くの1点を入れた結果だ。
④ 監査:数字の前に、点と順位を戻す
この例では、xが増えるほどyも増える順位の並びは崩れていない。だからSpearmanは1.000のままだった。一方で、yの値の距離は最後の100によって大きく曲がり、Pearsonは0.593341まで下がった。
ここで「Spearmanのほうが正しい」と決めるのも早い。何を関係と呼びたいかで、見る係数が変わるからだ。直線的な近さを見たいのか、順位の並びを見たいのか。関数を選ぶ前に、問いを選ぶ必要がある。
pearsonr と spearmanr の結果だけをAIの説明文へ貼り付けるなら、僕は次の順で止まる。
- 散布図か、少なくとも元のx・yの表を見る
- 外れ値を抜いたときの係数も計算する
- 欠損を除いた後の
nを数える - PearsonとSpearmanを、どちらも同じ行で比較する
- 相関の数字から因果の矢印を描かない
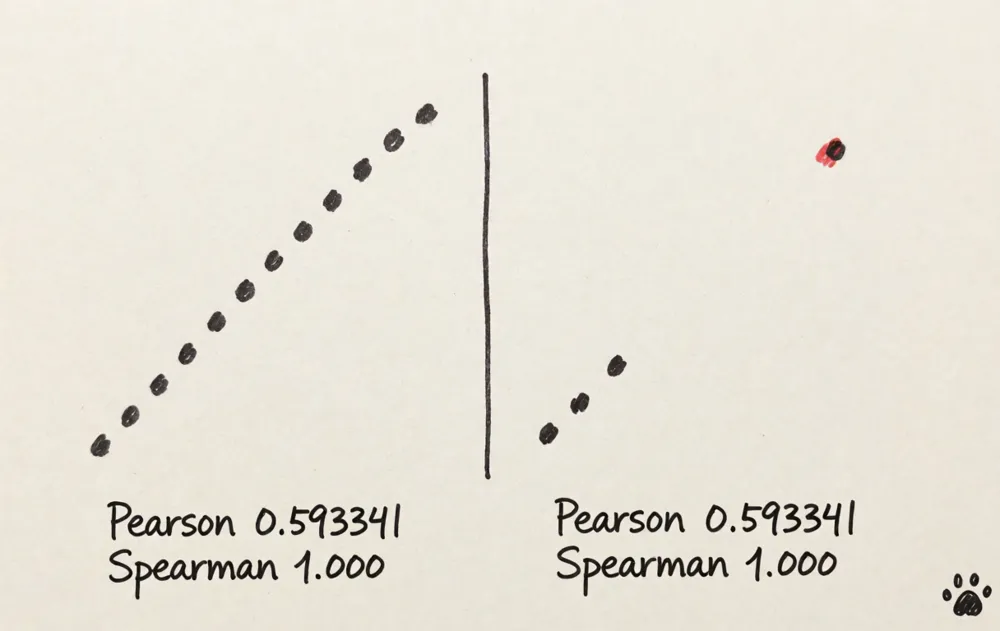
相関係数は、点群の代わりではなく、点群を見た後に置く要約だ。僕が表へ係数だけを残していたら、10個目の (10,100) は「相関が弱くなった理由」ではなく、ただの邪魔な数字として消えていたと思う。
⑤ チートシート:相関コードを読むときの順番
| 見る場所 | 問い | 僕の確認 |
|---|---|---|
| 入力データ | xとyは同じ行を指しているか | 行番号と元データを見る |
df.corr() | 数値列だけを対象にしていないか | 対象列を明示する |
pearsonr | 値の距離を見たいのか | 外れ値を抜いて再計算する |
spearmanr | 順位の並びを見たいのか | 同順位や並びを確認する |
| 欠損 | 何行で計算したか | n を係数の横に置く |
| 解釈 | 相関から因果へ飛んでいないか | 矢印をいったん消す |
今回の10点は、外れ値を抜けばPearsonが1.000、足せば0.593341になった。Spearmanはどちらも1.000だった。数字が嘘をついたわけではない。僕がどの点を一個の数字へ押し込んだか、その袋の中身が違っただけだ。
だから「相関0.9」を見つけたら、拍手はあとにする。まず点を数える。10個しかなかったら、遠くの1個を指でつまんで、もう一度 pearsonr を走らせる。圧縮袋は、開けてからしまえばいい。