R²は、回帰モデルに説明変数を足しても下がらない採点係だ。無関係な乱数列を答案に混ぜても、点だけは少し上がることがある。僕は summary() のいちばん目立つ数字を見て、「モデルが良くなった」と早合点しかけた。
① 用途:summary() はモデルの成績表をまとめて出す
statsmodels の OLS は、最小二乗法で線形回帰を当てはめる道具だ。fit() のあとに summary() を呼ぶと、モデル全体の指標、係数の表、残差診断などがまとまって表示される。便利なので、僕も最初は一番上の R-squared だけ見て閉じていた。
でも R² は「このデータのばらつきのうち、モデルが説明した割合」の要約であって、説明変数を増やした価値の判定札ではない。同じ目的変数・同じ観測行で、切片を含む通常の OLS に説明変数を追加すると、R² は下がらない。無関係な列を足しても、モデルが当てはめる余地は増えるからだ。
| summaryの場所 | 僕が読むもの |
|---|---|
| 上段 | 観測数、R²、調整済みR²、モデル全体の検定 |
| 係数表 | 係数、標準誤差、t値、p値、信頼区間 |
| 下段 | 残差の偏りや自己相関などの診断値 |
② 代表要素:R²の隣に調整済みR²がいる理由
sm.OLS(y, X).fit() でモデルを当てはめ、result.summary() で表示する。定数項は自動では足されないので、切片を使うなら sm.add_constant(X) を通す。ここを忘れると、切片なしの別モデルになる。
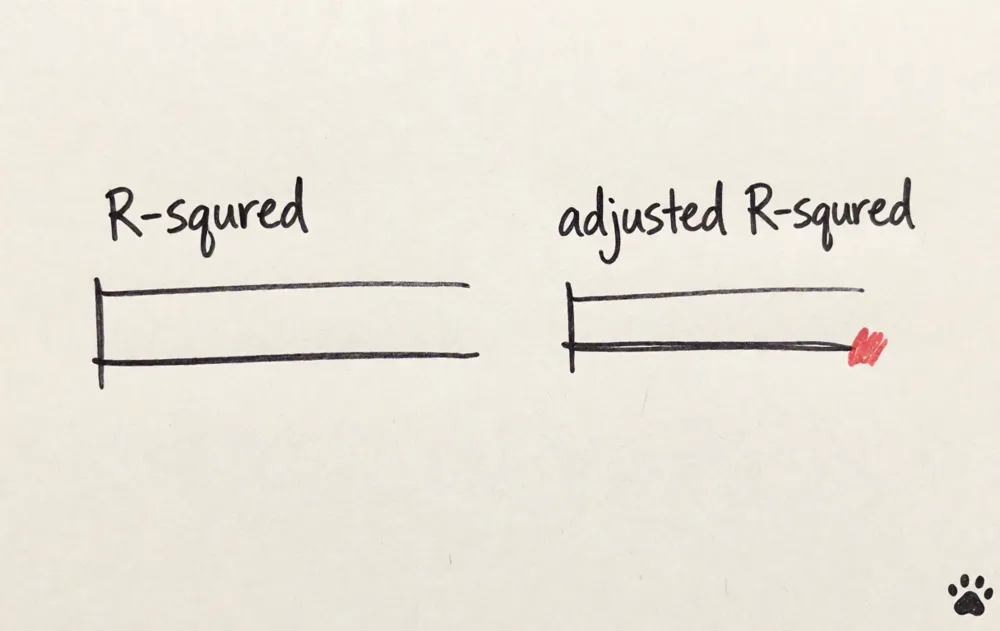
調整済みR²(rsquared_adj)は、説明変数の数と残差の自由度を考慮した指標だ。説明変数を足すと必ず上がる R² と違い、追加した列の改善が小さければ下がることもある。ただし、調整済みR²が上がっただけで予測性能が保証されるわけでもない。
| 項目 | ざっくり見る意味 |
|---|---|
rsquared | 今の標本への当てはまり |
rsquared_adj | 説明変数の数も考慮した当てはまり |
pvalues | 係数ごとの検定結果。因果の証明ではない |
③ AIが書く例:乱数列を足してsummaryを並べる
説明変数を1列追加したモデルを作り、R²が上がったから改善、と結論づけるコードは動いてしまう。そこで、同じ30件の y と x に、x と独立に作った乱数列 z を足し、実行結果を比べた。乱数の種も固定している。
import numpy as np
import statsmodels.api as sm

rng = np.random.default_rng(20260901)
n = 30
x = np.arange(1, n + 1, dtype=float)
y = 4 + 1.7 * x + rng.normal(0, 8, n)
z = rng.normal(0, 1, n)  # xとは別に生成した乱数列

base = sm.OLS(y, sm.add_constant(x)).fit()
with_noise = sm.OLS(y, sm.add_constant(np.column_stack([x, z]))).fit()

print(base.summary())
print(with_noise.summary())
僕の実行環境では、どちらも同じ30行を使い、出力の上段はこうなった。
summary() の項目 | xだけ | xとz |
|---|---|---|
| No. Observations | 30 | 30 |
| R-squared | 0.795 | 0.795(丸め前 0.794786) |
| Adj. R-squared | 0.787 | 0.780 |
z の係数表 `P> | t | ` |
丸め前のR²は 0.794701 から 0.794786 へ、ほんの少し上がった。一方、調整済みR²は 0.787368 から 0.779585 へ下がり、追加した z の係数のp値は 0.916 だった。乱数列はこの標本では説明にほとんど役立っていないのに、R²だけなら「良くなった」と読めてしまう。
④ 監査:数字の並びより、モデルに入れたものを見る
この実験の z は乱数から作った列だ。有限の標本では偶然の相関が出ることもあるし、p値が高いから「どんな条件でも無関係」と証明できたわけでもない。ここで見せたかったのは、変数を増やしたときR²は下がらず、調整済みR²や係数表は別の動きをする、という一点だ。
僕が summary() を開いたら、まず次を照らし合わせる。
| 見る場所 | 確かめること |
|---|---|
No. Observations | 比較するモデルで同じ行を使っているか |
R-squared / Adj. R-squared | 生の当てはまりと、変数数を考慮した値を混同していないか |
| 係数表 | 追加した列の係数・標準誤差・p値を見たか |
入力した X | 定数項を入れたか、列を増やした理由を説明できるか |
| 残差 | 残差の形や、データの並びに伴う偏りを別に確かめたか |
説明変数どうしが強く似ている場合は、多重共線性も気になる。VIFなど確認方法はあるけれど、ひとつの閾値だけで機械的に合否を決める話にはしない。summary() の係数表だけで診断が終わるわけでもない。
回帰の線が二つの数字の関係を描いても、それだけで片方がもう片方の原因とは言えない。相関と因果を分けた話は、公開済みの相関があっても因果とは限らない回に置いてある。
⑤ チートシート:summaryの数字を一段ずつ読む
| 表示・設定 | 僕が見るところ |
|---|---|
R-squared | 説明変数を足しただけで上がっていないか |
Adj. R-squared | 変数数を考慮すると、改善が残っているか |
No. Observations | 比較したモデルで観測行がそろっているか |
| `P> | t |
sm.add_constant(X) | 切片を含めるモデルとして組み立てたか |
| 残差・入力列 | summaryの外も含め、前提や偏りを確かめたか |
最初に見たのは、R²の 0.795 だった。そこだけなら、乱数の z を足した方が勝ったように見える。けれど隣の調整済みR²は 0.787 から 0.780 に下がっていた。答案にプリンの個数を書き足した採点係は、まだ満点を付けていない。