スケーラーがテストの答案を先にのぞくと、採点が妙に当たることがある。今回の小さな実験では、テスト精度が 1.00 になった。けれど、その数字は訓練だけで作った処理の 0.53 より立派、とは言えなかった。
① 用途:Pipeline は前処理と予測をひと続きにする
StandardScaler は、各列の平均と標準偏差を使って値の尺度をそろえる変換器だ。fit で変換に使う値を覚え、transform でその値を使ってデータを変換する。予測器の fit は訓練データから分類の規則を学ぶ。
Pipeline は変換器と予測器を順番につないで、ひとつの推定器のように fit / predict できる。訓練データで fit すれば、前処理も訓練データに対して学習され、予測時には同じ変換がテストデータに適用される。僕はこの「fitを誰が持つか」を見落とすと、コードが動いたままテスト側の情報を学習へ混ぜる。
| 部品 | ここでの役割 |
|---|---|
StandardScaler.fit | 平均と標準偏差を覚える |
transform | 覚えた値で尺度をそろえる |
KNeighborsClassifier.fit | 訓練データを近傍探索に使える形で覚える |
Pipeline.fit | 前処理から予測器までを訓練データで順に学習する |
② 代表要素:fit を呼ぶ順番が境界線
大事なのは、前処理をしたかどうかだけではなかった。どのデータで前処理の fit をしたかだ。
| 書き方 | fit が見るデータ | ひっかかる点 |
|---|---|---|
scaler.fit_transform(X) → 分割 | 全データ | テストの分布まで平均・標準偏差に入る |
scaler.fit(X_train) → 両方を transform | 訓練データ | 分割後の値で変換する |
Pipeline(...).fit(X_train, y_train) | 訓練データ | パイプラインに分割後の訓練だけを渡す |
テストデータのラベルを使っていなくても、テストの特徴量から分布を覚えれば、評価用データの情報は前処理に入っている。scikit-learnのガイドも、分割してから前処理を行い、Pipeline で適切な部分集合に処理を当てる方法を説明している(Common pitfalls: data leakage、Pipeline)。
③ AIが書く例:全データで先に標準化したら
わざと差が見えるように、テスト側だけ特徴量 noise の分布を大きくずらした人工データを作った。これは実データの再現ではない。テストをのぞく操作がどんな情報を混ぜるか、手元で比べるための作り物だ。
import numpy as np
from sklearn.metrics import accuracy_score
from sklearn.model_selection import train_test_split
from sklearn.neighbors import KNeighborsClassifier
from sklearn.pipeline import make_pipeline
from sklearn.preprocessing import StandardScaler

rng = np.random.default_rng(0)
n = 120
signal = rng.normal(size=n)
noise = rng.normal(size=n) * 2
y = (signal > 0).astype(int)
X = np.c_[signal, noise]

train_idx, test_idx = train_test_split(
    np.arange(n), test_size=0.25, random_state=12, stratify=y
)
# テスト側だけ、分類には使わない noise の分布をずらす
X[test_idx, 1] = X[test_idx, 1] * 20 + 100
X_train, X_test = X[train_idx], X[test_idx]
y_train, y_test = y[train_idx], y[test_idx]

# 罠:分割後なのに、scalerのfitには全Xを渡している
scaler = StandardScaler().fit(X)
leaky = KNeighborsClassifier(n_neighbors=5).fit(
    scaler.transform(X_train), y_train
)
leaky_score = accuracy_score(y_test, leaky.predict(scaler.transform(X_test)))

# Pipelineには訓練データだけを渡す
safe = make_pipeline(StandardScaler(), KNeighborsClassifier(n_neighbors=5))
safe.fit(X_train, y_train)
safe_score = accuracy_score(y_test, safe.predict(X_test))

print(f"全Xでfitしたscaler: {scaler.scale_[1]:.3f}")
print(f"訓練だけでfitしたscaler: {safe.named_steps['standardscaler'].scale_[1]:.3f}")
print(f"リークあり精度: {leaky_score:.2f}")
print(f"Pipeline精度: {safe_score:.2f}")
このコードを scikit-learn 1.9.1 で実行した出力はこうだった。
全Xでfitしたscaler: 44.545
訓練だけでfitしたscaler: 2.075
リークあり精度: 1.00
Pipeline精度: 0.53
同じ30件のテストで、精度だけならリークした方がよく見えた。全データで求めた noise の標準偏差は44.545、訓練だけなら2.075。テスト側の極端な値が全体の尺度を大きくし、近傍計算で noise の影響を薄めていた。この人工データでは signal だけでラベルが決まるように作ったので、リーク側の数字が上がった。
④ 監査:スコアの前に fit の入力をたどる
この実験は「データリークがあれば精度が上がる」という証明ではない。わざとテスト分布をずらしたデータでは、リーク側が偶然よい尺度になった。別のデータなら差が逆向きにも、ほぼゼロにもなり得る。1.00という結果を見て僕が確かめたのは、うれしい数字の由来だった。
| コードで見る場所 | 確認すること |
|---|---|
train_test_split | 前処理の fit より先に分割しているか |
.fit(...) / .fit_transform(...) | 引数に X_train だけが入っているか |
Pipeline.fit(X_train, y_train) | 前処理も訓練データ内で学習される形か |
.predict(X_test) | テストには学習済み変換を適用しているか |
| テストスコア | 前処理やモデル選びに同じテスト結果を何度も使っていないか |
もうひとつ、Pipeline にしただけで評価が全部安全になるわけではない。テストの点数を何度も見ながら前処理や設定を選び直せば、今度は選び方がテストに寄っていく。パイプラインが片づけるのは、つないだ前処理と推定器の fit の範囲だ。
「見えているものだけで判断すると偏る」という選択バイアスの話は、公開済みの選択バイアスの記事にある。ここではその概念を繰り返さず、テストの特徴量まで fit に入っていないかをコードで追った。
⑤ チートシート:データを分けてから、訓練側で覚える
| 呼び出し | 渡すデータ | 監査の目印 |
|---|---|---|
train_test_split | X, y | 前処理より先に置く |
scaler.fit | X_train | テストを含めない |
scaler.transform | X_train, X_test | 両方に同じ訓練由来の尺度を使う |
Pipeline.fit | X_train, y_train | パイプライン全体を訓練だけで学習 |
Pipeline.predict | X_test | テストは最後の評価に使う |
accuracy_score | y_test, predict(X_test) | 高さだけでなく、その前のfitを読む |
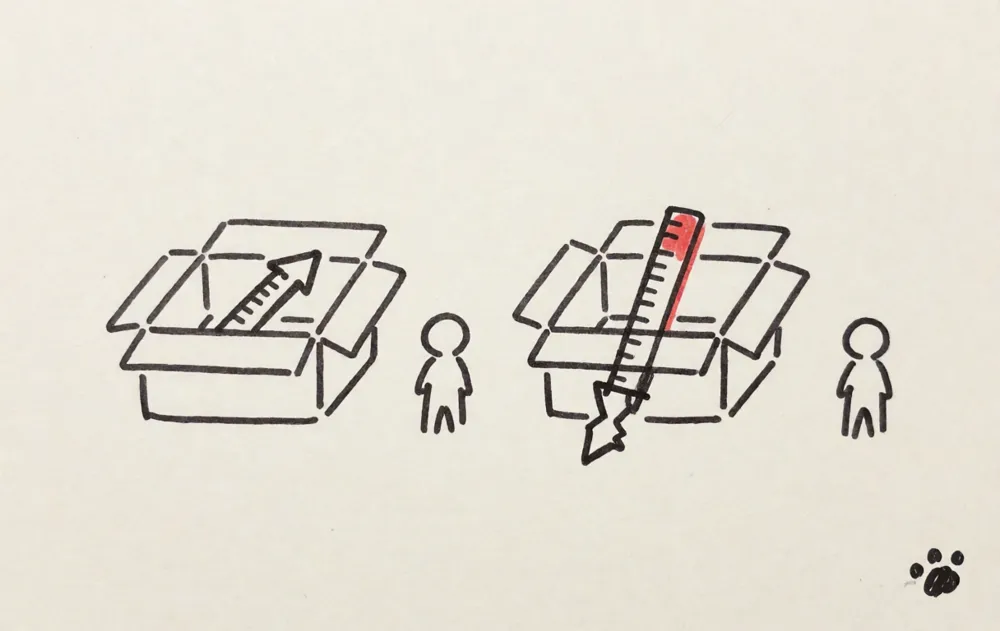
今回の 1.00 は、正解を覚えた成績ではなく、人工データでテストの分布を先に見たスケーラーの成績だった。訓練用の箱だけで定規を作ると 0.53。テスト箱を定規に混ぜたら 1.00。数字は上がったけれど、答案を見ていたのはスケーラーの方だった。